Cholesky 分解在不同平台上的性能异常
一个其实很不严谨的对比测试hhh
在实现数值代数课程的算法时,我发现 Cholesky 分解在 macOS 上的表现与教材的结论截然相反,于是就有了这篇分析。
教材结论
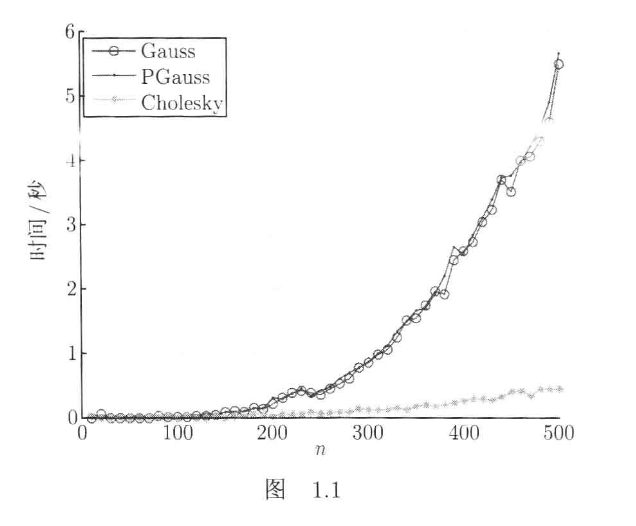
教材图 1.1 的基准测试显示,Cholesky 的耗时远低于 Gauss 消元法和列主元 Gauss 消元法的,n 越大差距越明显。理论复杂度也支持这一点:Cholesky 的时间复杂度大约是 \(O(\frac{n^3}{3})\),Gauss 是 \(O(\frac{2n^3}{3})\),浮点运算量少了一半。
测试方式
随机数设置
为保证数据生成的随机性,我们将随机数种子设置为
| C++ | |
|---|---|
数据生成
对于 \(n * n\) 的正定矩阵 \(A\),\(A = L L^T\),其中 \(L\) 是一个随机生成的下三角矩阵,\(L\) 的元素是服从区间 \([1, 2]\) 上的均匀分布的随机数。
对于 \(n\) 维的向量 \(b\),元素是服从区间 \([0, 1]\) 上的均匀分布的随机数。
耗时测试
我们在调用求解函数前后分别记录时间,从而计算出求解函数的耗时。
| C++ | |
|---|---|
测试结果
我们只关注 gaussSolve、PgaussSolve 和 choleskySolve 的数据。
macOS
测试环境: MacBook Air M3,Apple Clang 17.0.0
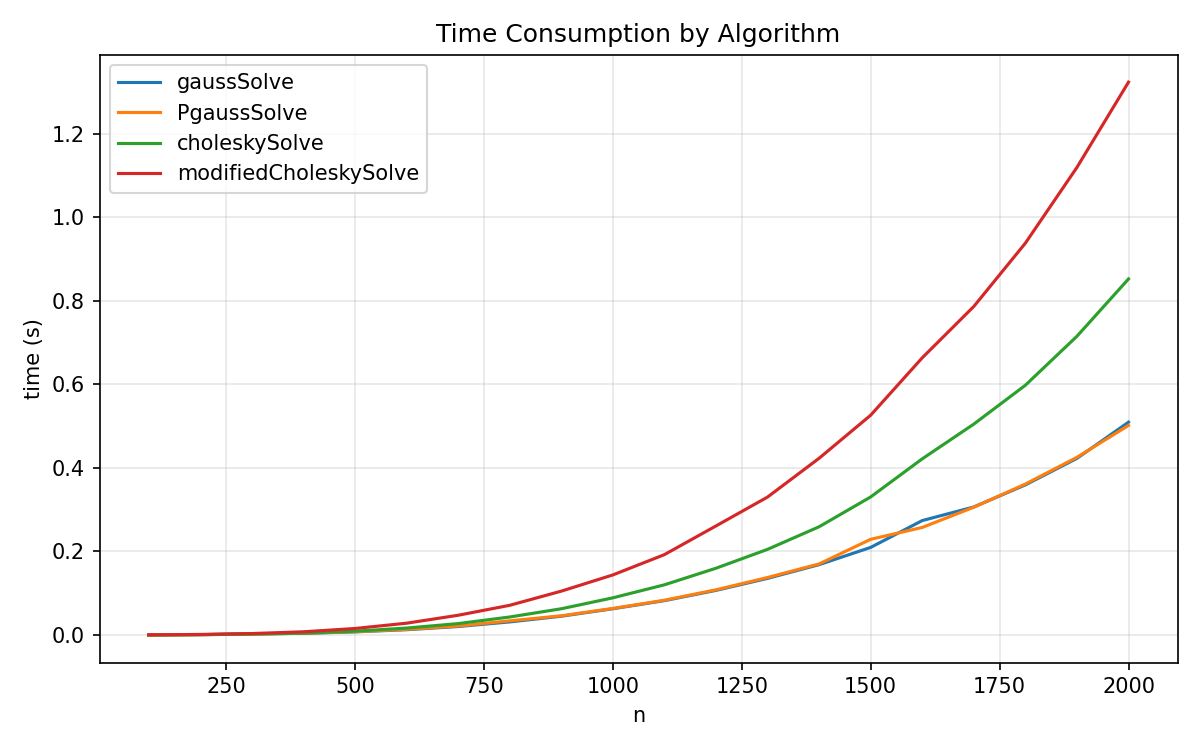
从图上能够看出,Gauss(蓝线) 和 Pgauss(橙线) 的耗时非常接近,而 Cholesky(绿线) 的耗时竟然比 Gauss 还高。
一开始我以为是代码实现有问题,但仔细检查了算法实现,确认没有错误。于是我决定在 Linux 系统上也跑一下同样的代码。
Linux
测试环境: Debian GNU/Linux 13 (trixie) aarch64,GCC 14.2.0 \ 其中硬件为 Raspberry Pi 5 Model B Rev 1.1
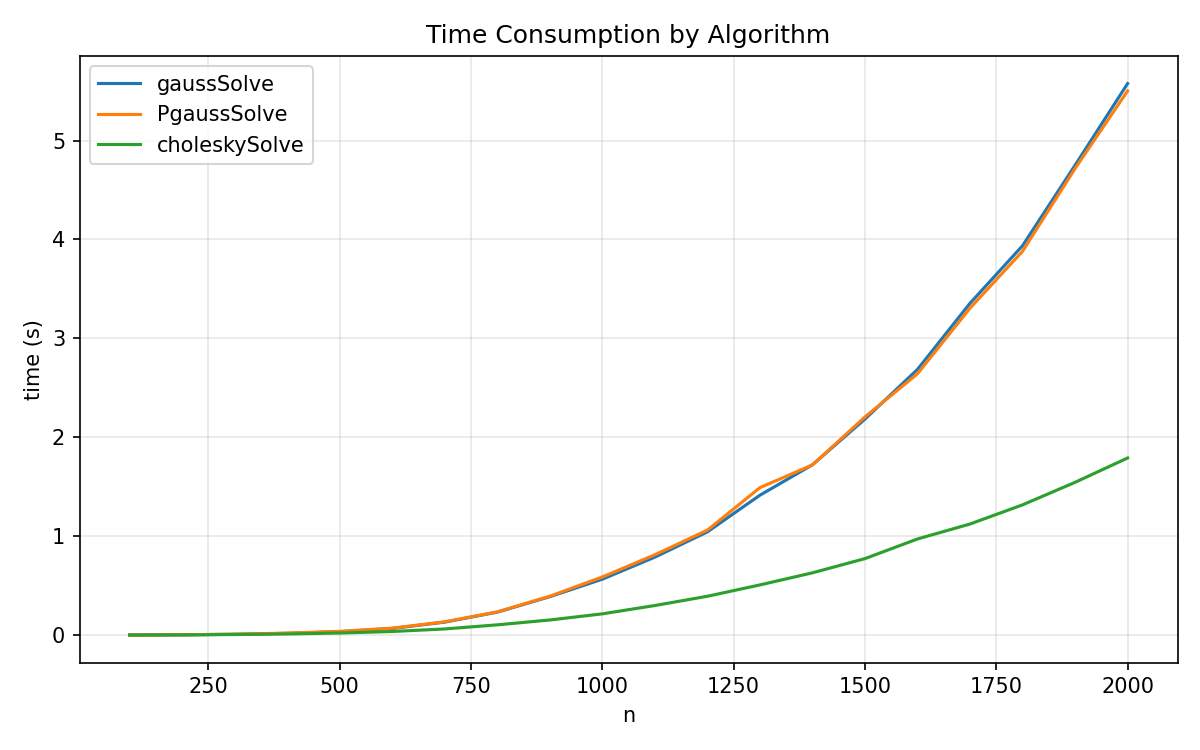
这个结果完全符合教材的结论,Cholesky 的耗时明显低于 Gauss。
结果比较
比较 \(n=2000\) 时的数据:
| 算法 | Debian | Mac |
|---|---|---|
| gaussSolve | 5.576s | 0.509s |
| PgaussSolve | 5.502s | 0.501s |
| choleskySolve | 1.790s | 0.852s |
树莓派上 Cholesky 比 Gauss 快 3 倍,跟教材结论大致一致。但 M3 上 Cholesky 反而比 Gauss 慢了 1.67 倍,跟教材的结论完全相反。
原因探究
编译器不同
我一开始是怀疑编译器不同导致的性能差异。树莓派上用的是 GCC,Mac 上用的是 Apple Clang。于是在 Mac 上换成了 GCC 13 进行编译运行:
| \(n=2000\) | Clang -O2 | GCC-13 -O2 |
|---|---|---|
| gaussSolve | 0.509s | 0.810s |
| choleskySolve | 0.852s | 1.300s |
结果发现,换成 GCC 后 Gauss 变慢了,但 Cholesky 也变慢了,并且还是比 Gauss 慢。
接着在 M3 上又试了 Clang -O3,结果跟 -O2 基本没差别,可以排除优化级别的问题。
结论:Apple Clang 相比 GCC 对 Gauss 的行连续循环做了更激进的优化,而 Cholesky 的列跳跃访问本身就难以被 SIMD 向量化,导致 Gauss 的耗时反而比 Cholesky 更低。
内存访问模式
既然换了编译器和优化级别都无法让 Cholesky 反超 Gauss,那问题可能出在代码本身。翻了一下代码,发现关键在 Matrix 的存储方式和各算法的循环结构上。
Matrix 用的是行主序(data[i * n + j]),同一行在内存里是挨着的。
Gauss 消元的内层循环:
j 每次加 1,访问的是同一行相邻的元素,内存连续,CPU 预取器工作得很舒服。
但 Cholesky 的内层循环:
k 每次加 1,但 L(i, k) 的地址是 data[i*n + k],步长是 n。n=2000 的时候每次跳 16000 字节,缓存根本跟不上。
所以 Gauss 的循环天然缓存友好,Cholesky 天然不友好。理论上 Cholesky 算得少,但实际花在等内存上的时间把优势吃掉了。
而 Apple Clang 对自家 ARM 芯片的 SIMD 向量化做了很深的优化,Gauss 那种规整的行连续循环被充分向量化,进一步放大了缓存优势。Cholesky 的列跳跃访问模式不适合 SIMD,也就没法从中受益。反观 GCC 在树莓派的 Cortex-A76 上比较保守,向量化没那么激进,两种算法的表现更接近理论值,Cholesky 的复杂度优势才得以体现。
缓存问题的学术背景
这个现象其实不稀奇,"理论复杂度和实际性能对不上"在矩阵算法里是个老话题了。
循环顺序决定缓存命运
MIT 18.337 课程(Applied Parallel Computing)的讲义里专门讨论过这个问题:Gaussian elimination 换一种循环嵌套顺序(比如从 ijk 换成 kij),性能就能差好几倍。中国力学期刊《有限元分析快速直接求解技术进展》也提到过,列主元存储 + KJI 消元和行主元存储 + IJK 消元的性能差异很大。说白了都是同一件事——内存连续不连续。
Cache-Oblivious Algorithms
Frigo 和 Leiserson 在 1999 年提了个思路:能不能设计一种算法,不需要知道具体硬件的缓存大小,在任何机器上都能自动跑出接近最优的 I/O 效率?他们管这叫 Cache-Oblivious 算法。对矩阵运算来说,做法就是把矩阵递归地切成小块,让每次操作的数据刚好塞进缓存。BLAS 的 Level-3 实现(比如 LAPACK 里的 Cholesky 分解)就是这么干的。
所以我们测试里用的朴素实现(无分块、无 padding)恰好就是 cache-oblivious 算法要解决的问题。BLAS/LAPACK 比手写代码快几十倍,缓存优化占了很大功劳。
Apple Silicon 为什么差距更大
Apple Clang 对自家芯片的向量化优化非常激进。Apple 的 NEON SIMD 单元支持 128-bit 向量操作,M3 之后还有矩阵乘法硬件加速。Gauss 消元那种内层循环步长为 1 的规整访问,编译器直接上 SIMD 指令,一次处理好几个浮点数,缓存优势被进一步放大。
Cholesky 就没这个待遇了——列跳跃访问不连续,SIMD 预取器根本没法工作,编译器的向量化优化无从下手。而 GCC 在树莓派 Cortex-A76 上本身就保守得多,SIMD 加速没那么多戏可以唱,两种算法反而更接近理论值,Cholesky 的复杂度优势才体现出来。
相关资料
- AlgoWiki: Cholesky decomposition - 算法的内存访问模式和并行策略分析
- MIT 18.337: Lecture Notes - 矩阵算法中的缓存问题
- Frigo et al., 1999: Cache-Oblivious Algorithms - 不依赖硬件参数的缓存最优算法
- UT Austin: The Cache-Oblivious Gaussian Elimination Paradigm
- Matlab 社区: Why is the built-in chol() so much faster than my implementation?
总结
教材的结论没问题,Cholesky 理论上就是更快。但教材没说清楚的是,实际跑起来不光看运算量,还得看内存访问模式、编译器优化和 CPU 微架构。在 Apple Silicon + Apple Clang 上,Gauss 的行连续访问被硬件和编译器吃得死死的,Cholesky 的理论优势反而被盖过去了。
说到底就是一句话:FLOPs ≠ Performance。运算量只是一个维度,内存带宽、缓存命中率、向量化和指令级并行同样关键。这也是为什么 BLAS/LAPACK 这种优化了几十年的库才是工程首选,手写朴素实现基本没戏。
可能的优化方案
- 列主序存储 L:用列主序单独存储下三角矩阵,让 Cholesky 点积的内层循环变成连续访问(代价是需要额外的转置或存储开销)
- Cache Blocking(分块):将矩阵分为适合 L1/L2 缓存大小的子块,在块内进行计算。这是 BLAS Level-3 实现的核心策略
- 调用优化库:直接调用 BLAS(Mac 上可用 Accelerate 框架,Linux 上用 OpenBLAS),这些库已经做了分块、向量化、多线程等全套优化
- 循环交换:尝试交换 Cholesky 的循环嵌套顺序(ijk → jki 等),使内层循环变为行连续访问
- 手动优化:编译器提示(如
#pragma omp simd)、手动预取指令(__builtin_prefetch)或循环展开